


La competencia entre los diferentes actores presentes en la carrera de la IA es palpable. Si una plataforma lanza una novedad, las otras no tardan en igualarla. Hace poco hablábamos de la mejora en la voz de ChatGPT, para ser más real que nunca, y ahora le toca el turno a Gemini.
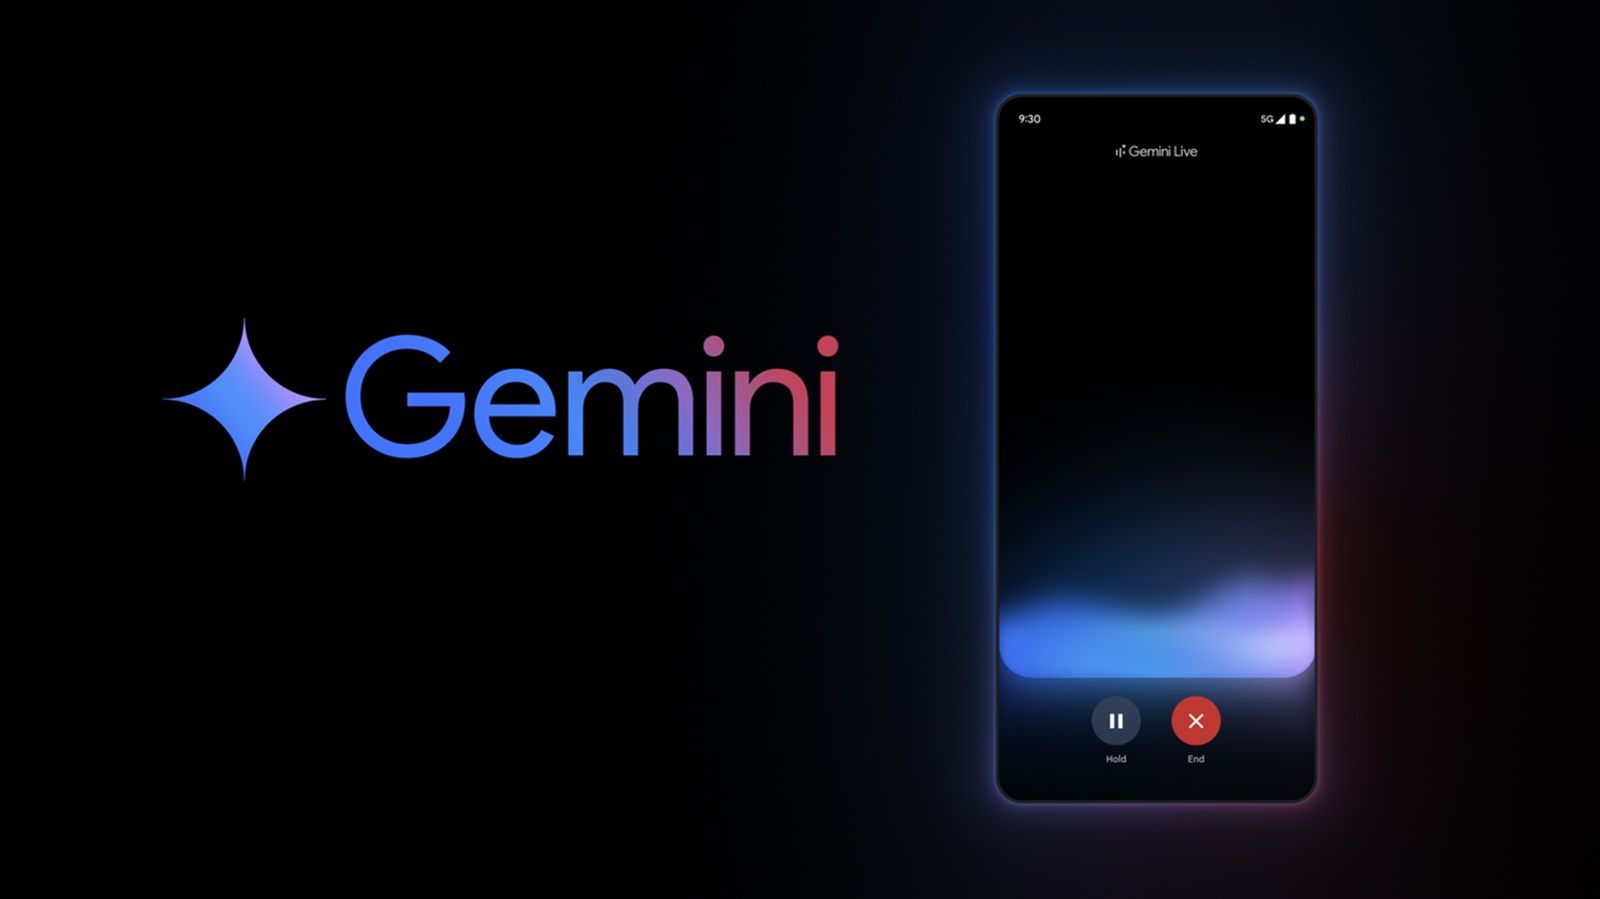
Google ha presentado Gemini 3.8 Live y Gemini 3.8 Live Extended Thinking, dos nuevos modelos de conversación por voz capaces de mantener un diálogo natural mientras procesan información y realizan otras tareas en segundo plano. La compañía asegura que son sus modelos de diálogo en directo más avanzados hasta la fecha.
Dos nuevos modelos de Gemini Live
Hablar con la IA es cada vez más habitual, pero también más natural. Atrás quedaron las robóticas conversaciones que dejaban claro quién era el humano y quién la máquina. El futuro pasa porque alguien que esté escuchando la conversación desde fuera no sepa quién es quién. Es el objetivo de Google hacer cada vez más realista y preciso el modo de voz en tiempo real de Gemini.

Gemini 3.8 Live
Este nuevo modelo está diseñado para funcionar a gran escala. Su objetivo es ofrecer conversaciones fluidas, respuestas rápidas y comprensión visual en tiempo casi real. El modelo puede interpretar lo que ocurre delante de la cámara, utilizar ese contexto durante la conversación y cambiar automáticamente entre 97 idiomas compatibles.
También puede ejecutar llamadas a herramientas y API en segundo plano mientras continúa hablando con el usuario. Por ejemplo, podría ayudar a configurar una aplicación mientras revisa un documento que se está mostrando por cámara, o consultar información en segundo plano sin interrumpir la conversación.

Gemini 3.8 Live Extended Thinking
Esta segunda novedad va más enfocada a tareas más complejas. Puede analizar problemas de varios pasos, coordinar distintas acciones y mantener la conversación mientras realiza ese trabajo. En vez de quedarse callado durante varios segundos, puede utilizar frases como “déjame comprobarlo” y ofrecer pequeñas actualizaciones sobre su progreso.
Google deja claro que el modelo razona y habla simultáneamente, una característica especialmente útil para agentes de voz que tienen que completar tareas largas. En los asistentes de voz tradicionales, el sistema suele escuchar la petición, dejar de responder mientras procesa la información y regresar con una respuesta cuando ha terminado.
Pensado para desarrolladores y empresas
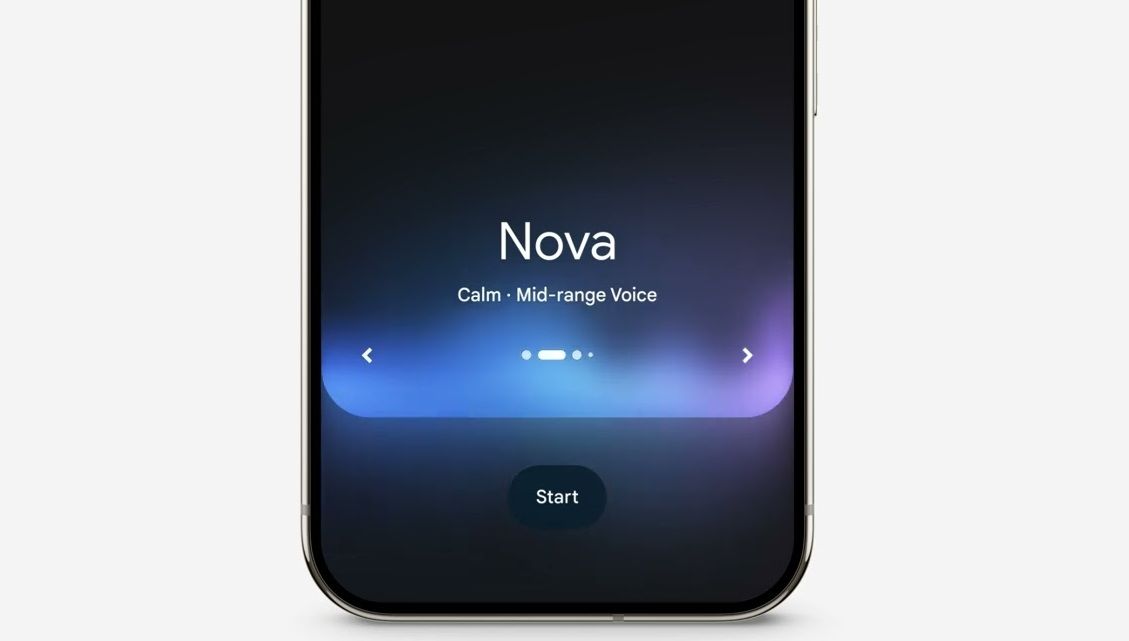
Google está poniendo estos modelos a disposición de los desarrolladores mediante Gemini API y Google AI Studio. Pero los usuarios también podrán probarlos, ya que Gemini 3.8 Live Extended Thinking se incorpora a Gemini Live. Los suscriptores de Google AI Pro y Ultra pueden utilizarlo en Docs dentro de Workspace, mientras que los suscriptores de Google AI también tienen acceso a funciones relacionadas en Gmail y Keep.
Dentro de la transparencia que se le está dando a todo lo generado por IA, Google asegura que todo el audio generado por sus productos de inteligencia artificial incorpora una marca de agua SynthID. Esta marca es imperceptible para las personas y se integra directamente en el audio. Su objetivo es facilitar la detección de contenido generado por IA y ayudar a combatir la desinformación.